105. 从前序与中序遍历序列构造二叉树#
现实映射:破碎陶罐的复原#
考古学家发现了一个破碎的陶罐,残片上记录着两种特殊符号序列:
- 前序符号:按”中心→左→右”顺序记录的图案
- 中序符号:按”左→中心→右”顺序记录的图案
现在需要根据这两种符号序列,复原陶罐原本的立体结构。这正是我们今天要解决的算法难题!
问题描述#
题目目标#
LeetCode第105题要求:给定两个整数数组preorder和inorder,其中preorder是二叉树的前序遍历,inorder是同一棵树的中序遍历,请构造并返回这颗二叉树。
示例 1#
输入:
preorder = [3,9,20,15,7]
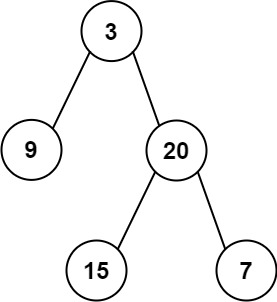
inorder = [9,3,15,20,7]输出: [3,9,20,null,null,15,7]
二叉树示意:
 3
/    \
9   20
   /  \
15 7说明: 前序遍历先确定根节点 3,再结合中序遍历划分左右子树,就能还原出图中的二叉树。
补充说明#
- 二叉树通常使用层序数组表示,
null表示该位置没有节点。
直觉解法:递归分治#
就像考古学家分层剥离土层,我们可以用分治策略层层解析:
- 定位根节点:前序数组的第一个元素是根节点
- 划分左右区间:在中序数组中找到根节点,左边是左子树,右边是右子树
- 递归构建:根据区间长度切割前序数组,递归构建左右子树
Java实现#
class Solution {
    public TreeNode buildTree(int[] preorder, int[] inorder) {
        // 从前序与中序的完整区间开始递归构建
        return build(preorder, 0, preorder.length-1,
                    inorder, 0, inorder.length-1);
    }

    private TreeNode build(int[] pre, int preStart, int preEnd,
                          int[] in, int inStart, int inEnd) {
        // 递归终止条件:前序区间为空时,没有节点可构建
        if (preStart > preEnd) return null;

        // 前序区间第一个元素一定是当前子树根节点值
        int rootVal = pre[preStart];
        // rootIndex 记录根节点在中序数组中的位置
        int rootIndex = -1;
        // 在线性区间中查找根节点位置(O(n))
        for (int i = inStart; i <= inEnd; i++) {
            if (in[i] == rootVal) {
                rootIndex = i;
                break;
            }
        }

        // 左子树节点个数 = 中序中“根左侧元素个数”
        int leftSize = rootIndex - inStart;

        // 创建当前根节点
        TreeNode root = new TreeNode(rootVal);
        // 递归构建左子树:
        // 前序区间:[preStart+1, preStart+leftSize]
        // 中序区间:[inStart, rootIndex-1]
        root.left = build(pre, preStart+1, preStart+leftSize,
                         in, inStart, rootIndex-1);
        // 递归构建右子树:
        // 前序区间:[preStart+leftSize+1, preEnd]
        // 中序区间:[rootIndex+1, inEnd]
        root.right = build(pre, preStart+leftSize+1, preEnd,
                           in, rootIndex+1, inEnd);
        // 返回当前构建完成的子树根节点
        return root;
    }
}复杂度分析
时间复杂度:O(n²)(每次递归需要线性查找根节点)
空间复杂度:O(n)(递归栈深度)
忍者解法:哈希表预处理的奥义#
真正的考古大师会提前制作符号索引表!通过预处理中序数组,我们可以将时间复杂度优化到线性级别。
核心优化点#
- 哈希映射:预先存储中序数组的值与索引的对应关系
- 全局指针:使用指针跟踪前序数组的构建进度
关键步骤演示(以示例说明)#
中序哈希表:{9:0, 3:1, 15:2, 20:3, 7:4}

构建过程:
1. pre[0]=3 作为根,中序中索引1
   → 左子树区间[0,0],右子树区间[2,4]
2. 递归构建左子树:pre[1]=9
   → 中序索引0,无左右子树
3. 递归构建右子树:pre[2]=20
→ 中序索引3,分割左右区间...Java实现#
class Solution {
    // 哈希表:中序值 -> 对应索引,用于 O(1) 定位根节点分割点
    private Map<Integer, Integer> inMap = new HashMap<>();
    // preIndex 指向当前应作为“根”的前序元素位置
    private int preIndex = 0;

    public TreeNode buildTree(int[] preorder, int[] inorder) {
        // 预处理中序数组,建立值到索引的映射
        for (int i = 0; i < inorder.length; i++) {
            inMap.put(inorder[i], i);
        }
        // 从中序完整区间 [0, n-1] 开始构建
        return build(preorder, 0, inorder.length-1);
    }

    private TreeNode build(int[] pre, int left, int right) {
        // 递归终止条件:区间为空,返回 null
        if (left > right) return null;

        // 取前序当前元素作为根节点值,并将指针后移
        int rootVal = pre[preIndex++];
        // 创建根节点
        TreeNode root = new TreeNode(rootVal);

        // O(1) 查到根节点在中序中的位置,作为左右子树分割点
        int rootIndex = inMap.get(rootVal);

        // 先构建左子树(中序 left 到 rootIndex-1)
        root.left = build(pre, left, rootIndex-1);
        // 再构建右子树(中序 rootIndex+1 到 right)
        root.right = build(pre, rootIndex+1, right);
        // 返回当前子树根节点
        return root;
    }
}复杂度分析
时间复杂度:O(n)
空间复杂度:O(n)(哈希表存储)
解法对比#
| 方法 | 时间复杂度 | 空间复杂度 | 优势 |
|---|---|---|---|
| 递归分治 | O(n²) | O(n) | 无需额外空间 |
| 哈希预处理法 | O(n) | O(n) | 时间效率最优 |
模式总结#
本题体现了两个关键算法思想:
- 分治递归:将复杂问题分解为子问题递归求解
- 空间换时间:通过预处理建立快速查询结构
这种模式可以扩展到:
- 从中序与后序遍历构造二叉树
- 从前序与后序遍历构造二叉树(需特殊处理)
- 其他需要定位分割点的问题
考古大师心法#
优秀的算法设计就像文物复原:
- 定位锚点:快速找到关键分割点(根节点)
- 分层解析:递归处理各个结构层次
- 工具准备:预先建立索引工具(哈希表)提升效率
记住:当遇到需要频繁查找元素的场景时,不妨先问问自己——能否通过预处理建立快速访问的通道?